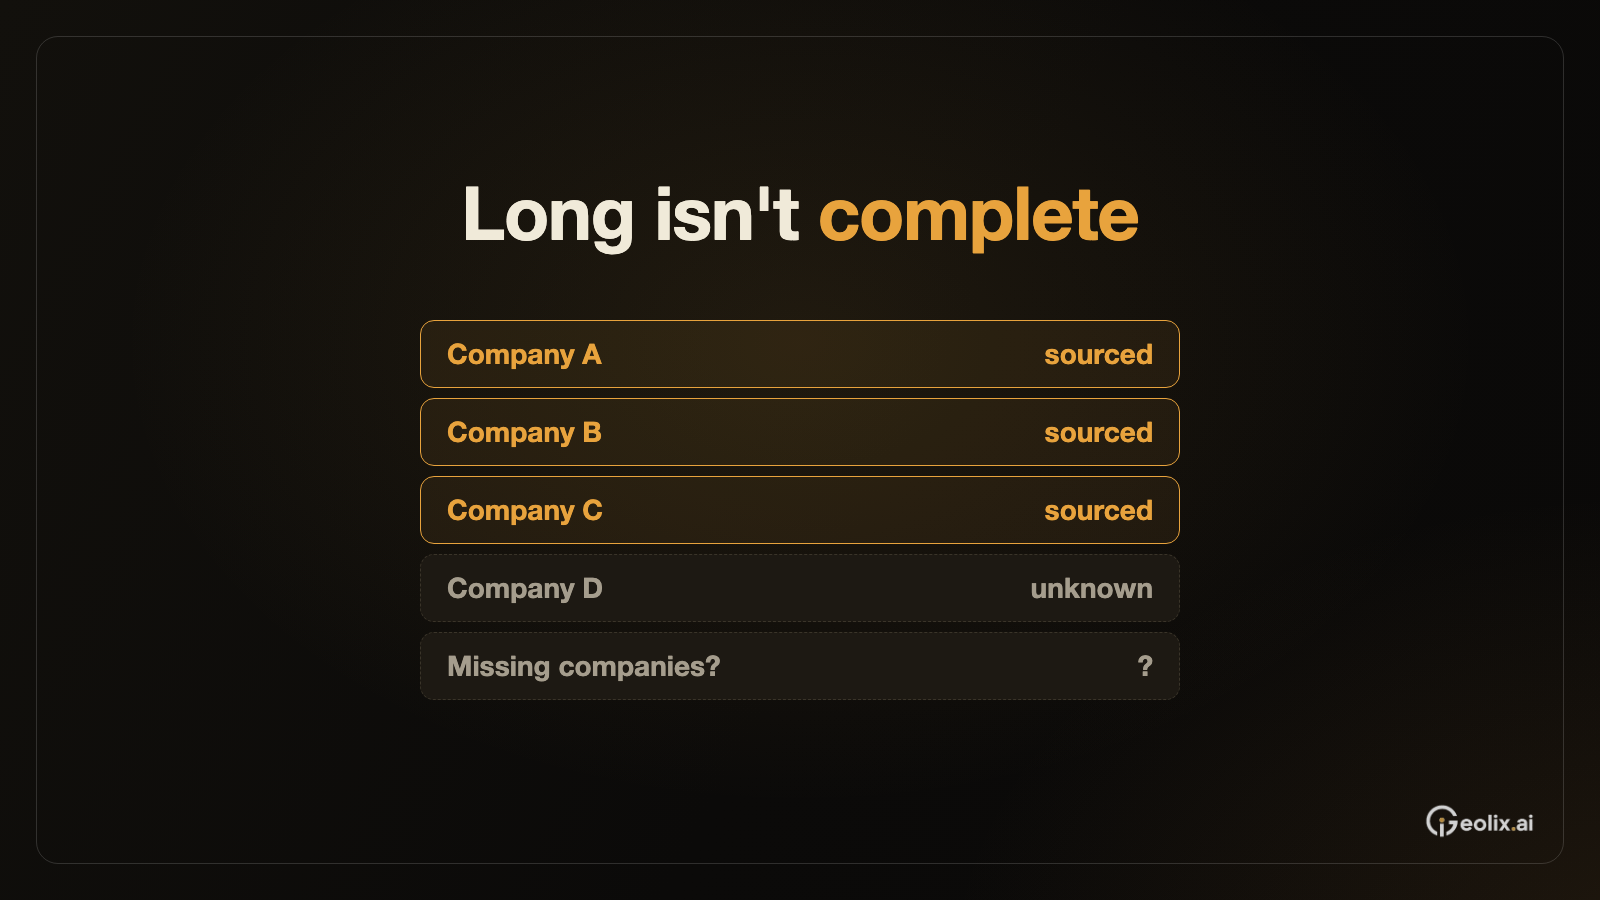
一份行业报告列出了十家企业,也附上了很多链接。研究团队仍然要问:应该纳入的企业是否已经找全?每家是否都经过相同标准的核查?长报告可能写得完整,却没有完成完整的研究范围。
Perplexity 的Deep Research 产品介绍描述了多轮搜索、阅读和整理报告的流程。这类产品能减少收集资料的工作,但企业还需要事先定义自己要验收的研究任务。
先列出名单的纳入条件
假设任务是找出服务某地区、支持某类部署的软件公司。团队应先规定纳入条件和证据要求。如果条件只存在于研究人员脑中,模型列出十个熟悉名字,也可能被误认为完整市场清单。
数量目标同样不等于覆盖标准。要求“至少二十家”可能让结果更长,却不说明遗漏了谁,也不说明名单中的每家是否符合条件。研究负责人需要说明哪些情况应排除,哪些信息未知时只能暂列待核实。
覆盖范围和准确性分开检查
Perplexity 发布的DRACO 研究评估论文讨论了复杂研究任务及相应评估。它是厂商发布的研究框架,不能直接证明某份实际报告可靠;但其中对准确性、覆盖和引用的分别检查,有助于企业明确验收对象。
对一份供应商报告,可以一方面检查发现过程是否只集中在少数常见来源,另一方面逐项核对纳入者是否有支持关键条件的材料。一个企业名称有来源,不代表它的地域覆盖、当前产品能力和部署条件都已确认。
没有查到材料时应保留“未知”。把未知自动写成“不支持”,会造成错误排除;把目录里的简短介绍直接扩写成详细能力,则可能制造未经证实的结论。
把未解决的问题留下来
复核后,最有用的产物可能是一组尚未解决的问题。缺少来源的字段需要补查,互相矛盾的资料需要确认时间和版本,边界模糊的公司需要重新应用纳入规则。
这比让模型把全文再写得流畅一点更能改善研究。公司也可以把这些未解决项交给熟悉行业的人,集中核查最可能影响决策的部分。
企业采用研究型 AI 时,应该保存任务范围、纳入规则和结果背后的来源。报告篇幅只是交付形式,覆盖范围有没有完成,需要用这些记录判断。