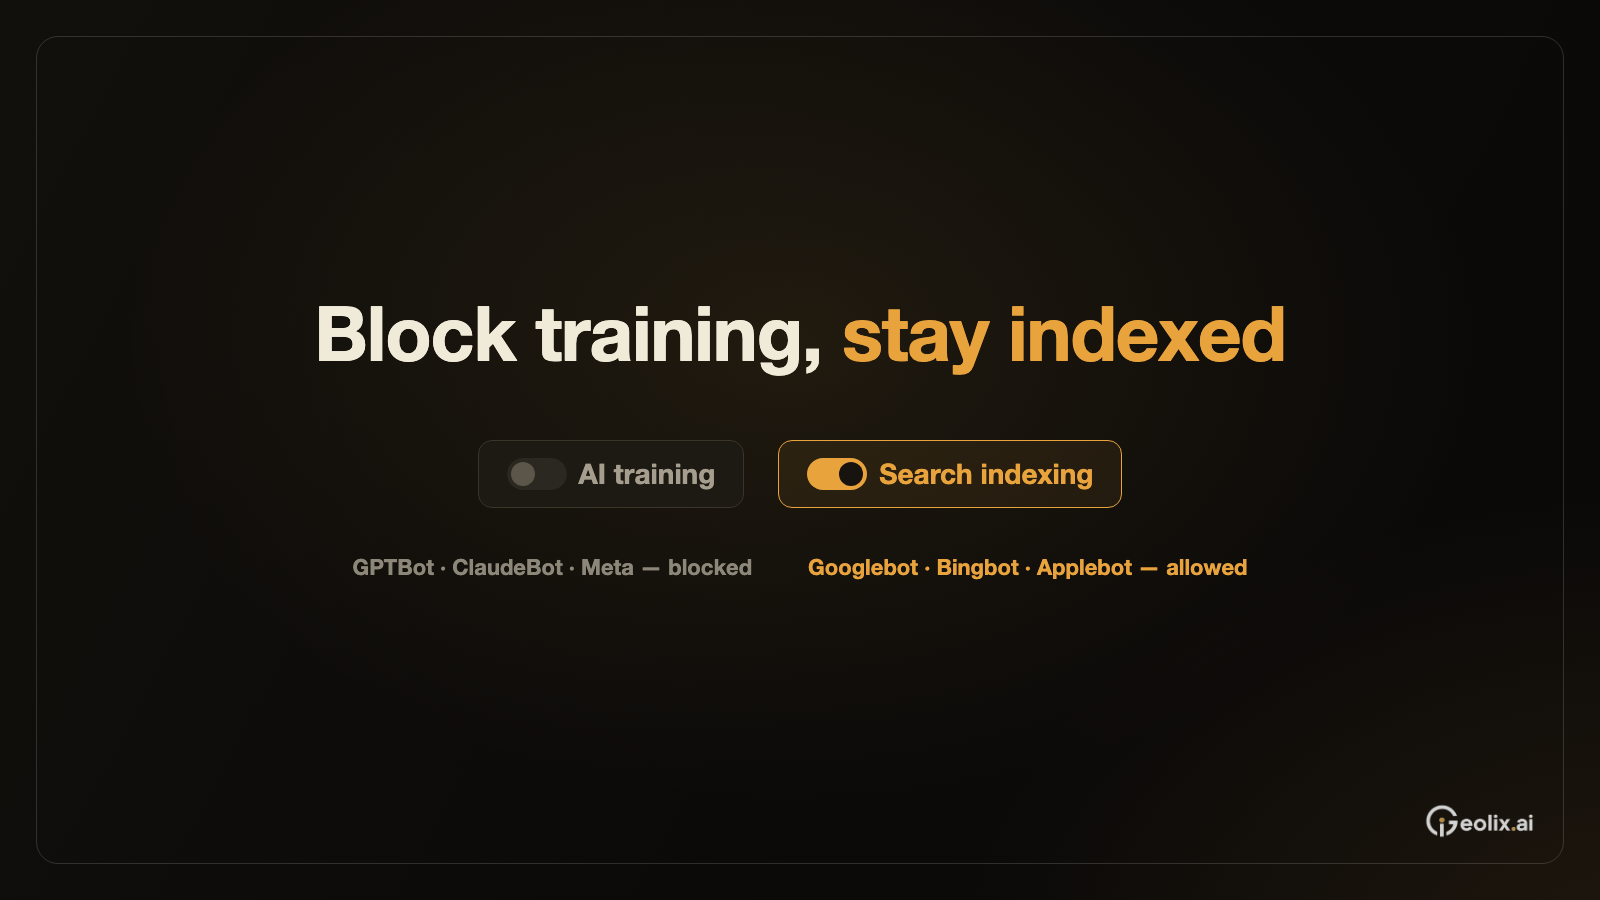
Cloudflare 9 月 15 日在 Bot Management 与 AI Crawl Control 中新增 Disallow AI Training 设置。站点可在 robots.txt 中声明拒绝内容用于模型训练,同时允许 Googlebot、Applebot、Bingbot 继续为搜索收录抓取。该功能对全部套餐开放。
过去的症结在混用型爬虫。Google、Apple、Microsoft 用同一个爬虫标识既建搜索索引又采训练数据,Cloudflare 7 月上线的 Search、Training、Agent 三类控制沿用了「身兼数职就全部规则叠加」的逻辑,站长一拦训练,搜索抓取跟着被拦。新设置把两件事拆开:Bot Preference Sync 负责把拒绝训练的指令写进 robots.txt,纯训练爬虫(包括 Amazon、Anthropic、Meta、OpenAI 旗下的)由 Cloudflare 在上游基础设施直接拦截,混用型爬虫放行做搜索,训练限制交由运营方遵守。Cloudflare 自己也承认边界:robots.txt 拦不住无视它的爬虫,所以配套做了爬虫身份识别,并在 Radar 上公开各家运营方的实际行为。heise online 的定性更直接:对混用爬虫而言,这仍是一份行为准则,不是访问控制。
哪些爬虫享受「保搜索」待遇,取决于 Cloudflare 自创的 Accountable 认定。这套认定并非第三方认证,属于该公司 7 月起与各爬虫运营方逐一沟通后自定的门槛,共四条:提供 robots.txt 或类似标准的训练退出机制;提供 AI 摘要退出机制,现在向运营方直接设置、明年起可通过 Cloudflare 设置;提供 URL 级透明度,说明哪些页面被用于训练、内容在搜索中表现如何;保证退出训练不影响传统搜索结果。Apple、Google、Microsoft 以「已上线功能加限期承诺」的组合过线。
三家的落地进度并不齐。Google 侧通过 Disallow Google-Extended 实现,官方文档称不影响搜索收录与排名;至于内容是否出现在 AI Overviews 和 AI Mode,由 Search Console 里另一个开关管,两者互不干涉。Apple 侧走 Applebot-Extended。Bing 是短板:Microsoft 的 robots.txt 域级拒绝训练支持要到 2027 年初,眼下 Cloudflare 的新设置对 Bing 不生效,站长只能继续用 NOARCHIVE 标签,按 Bing 文档,标注内容不进微软生成式模型训练,Copilot 和 Chat 也不给链接。Google 未来数周会推出 Google-Extended 的 URL 级透明工具,Apple 的对应工具排在明年。
老用户要留意语义变化:Block 和「广告页拦截」过去不碰混用型爬虫,现在一并生效,选 Block 等于连搜索抓取一起谢绝。存量配置自动迁移,原先 Training 下的拦截统一转为 Disallow AI Training,旧的 Block AI Bots 开关和托管 robots.txt 功能弃用;靠广告变现的新域名,默认预设即拒绝训练。Cloudflare 称绝大多数客户无需动手。该公司数据显示,拦搜索爬虫的站点不到 1%,启用某种训练拦截的有 17%,需求的不对称正是这次拆分的由头。
Cloudflare 已在 CDN 层面为 Google 和 Apple 拆分训练政策与搜索可见性,Microsoft 也承诺为 Bing 提供相应支持。此前为保护内容而拦截全部 AI 爬虫的站点,可以调整规则而不放弃搜索抓取。新广告站点又将默认拒绝训练,预计会有更多网页保持可检索,同时不向模型训练开放。Cloudflare 称 AI 搜索引荐的转化率是传统搜索的 3 至 5 倍;如果这一数据成立,计划于 2027 年初推出的 AI 摘要控制,可能比本次训练开关更直接地影响品牌可见性。