核心结论:谷歌说明 robots.txt 主要控制合规爬虫能否抓取内容,并不直接规定抓取后的使用方式;AI 营销团队还需分别核对品牌提及、引用、搜索表现与商业结果。
核心结论
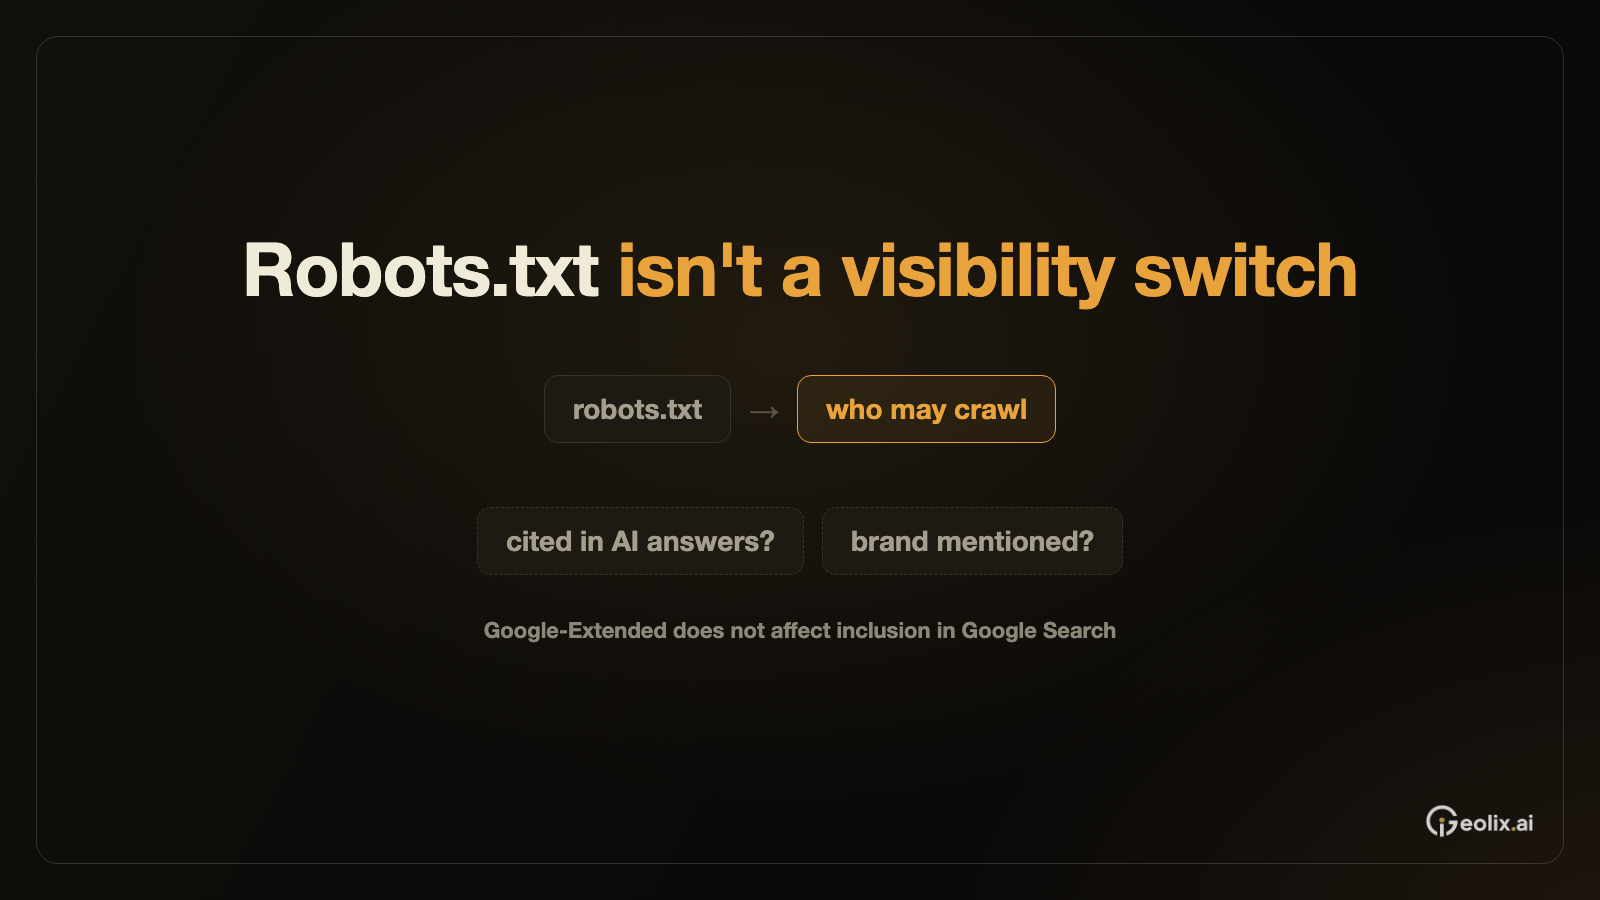
如果读者的问题是“设置 robots.txt 后,品牌就能控制自己是否出现在 AI 搜索答案里吗”,现有公开信息支持的答案是否定的。谷歌 Search Central 的说明把标准 robots.txt 规则限定为对合规爬虫的抓取许可,而不是对内容被抓取后如何使用的全面控制。Google-Extended 可用于表达与 Gemini 训练、Gemini Apps 和 Vertex AI grounding 相关的使用偏好,但它不是独立爬虫,也不会影响网页进入 Google Search。与此同时,关于 AI 搜索可见度的商业报道把品牌提及、来源引用、展示次数、份额、传统搜索表现和内容带来的点击或销售分开衡量。对 AI 营销团队而言,robots.txt 是访问控制的一部分,不是可见度、推荐或转化的保证。
谷歌 robots.txt 能控制什么以及不能控制什么
谷歌 Gary Illyes 表示,依据 RFC 9309,标准 robots.txt 指令规定的是合规爬虫获准抓取哪些内容。网站可以针对特定的 user-agent token 设置规则;如果希望阻止某个爬虫访问列出的路径,Disallow 是一种可用方式。Google 的爬虫文档还列出 Google-Extended,用来管理已经由 Google 抓取的内容是否可用于未来 Gemini 模型训练,以及 Gemini Apps 和 Vertex AI 中的 grounding。原文同时明确,Google-Extended 不影响 Google Search 中的收录。
这一区分直接影响 SEO 和 AI 搜索治理。阻止抓取不等于撤回已经被获取的内容,也不等于规定所有后续系统如何处理内容。原文提到,关于在 robots.txt 中加入 Content-Usage 规则、单独表达内容使用偏好的方案仍是工作组草案,尚未获批准。因此,团队不应把尚未成为标准的机制当作当前可依赖的控制项,也不能把一个 token 的规则扩大解释为对所有 AI 代理的统一指令。
如果网站正在处理短期 PHP 补丁停机,谷歌建议返回 503,而不是一般的 404 或 200 错误页,以便保留已经收录的 URL;其抓取文档建议 503 不要持续超过一至两天。这个事实属于搜索可用性和临时停机处理,并不能证明 robots.txt 或 503 会让品牌在 AI 搜索中获得更高推荐概率。团队应把可抓取性、收录状态和 AI 答案中的品牌表现分开记录。
AI 营销团队应如何衡量搜索可见度
关于 LLM visibility 的报道把目标定义为:品牌是否出现在 AI 生成答案中、哪些来源支持答案,以及品牌在相关问题下出现得有多频繁。报道提到的衡量项包括 AI mentions、citations、impressions 和 share of voice,同时也包括 Google 搜索中的自然表现、内容浏览、点击和通过 affiliate links 或 UTM 参数追踪的销售。这些指标回答的是不同问题,不能因为某个指标上升,就自动推断另一个指标也上升。
报道中的机构案例和数字均来自该机构的媒体资料,并非谷歌对 AI 搜索排名的官方保证。该资料声称其服务结合 Reddit marketing、高权威编辑内容和效果衡量,并报告了超过 15,000 次 AI citations、超过 160 million 次排名讨论浏览量,以及一个健康与 wellness campaign 在四个月内 AI mentions 增长 200% 的案例。原文同时说明,这些结果是机构自报;平台级研究数字也不代表任何单条讨论一定会被 AI 系统引用。对读者来说,更稳妥的任务不是复制这些结果,而是为目标查询建立可复核的基线:记录品牌是否被提及、是否有来源被引用、竞争品牌出现频率如何,以及是否产生可追踪的网站行为。
这也解释了为什么 SEO 与 AI marketing 需要并行检查。公开讨论和编辑内容可能通过社区、Google 搜索或 AI 生成回答形成不同的发现路径,但被发现不等于获得引用,被引用也不等于产生访问或销售。robots.txt 只能回答部分“哪些合规爬虫可以抓取”的问题;它不能替代内容相关性、来源质量、查询覆盖或商业归因的核验。
方法与局限
团队可以先审查 robots.txt 中面向不同爬虫 token 的 Allow 和 Disallow 规则,再对照 Google-Extended 及相关平台各自的公开文档,确认每条规则的对象和范围。随后,为一组明确的产品、服务或比较型查询建立固定测试集,定期记录 Google Search、Gemini 或其他 AI 搜索产品中是否出现品牌、引用了哪些来源,以及是否存在展示、点击和 UTM 或 affiliate 记录。报告时应把抓取、收录、提及、引用、流量和销售分栏,避免把相关性写成因果关系。
公开信息没有证明:某项 robots.txt 设置能够保证或阻止品牌出现在所有 AI 搜索答案中;也没有证明第二篇报道中的机构方法可以复制到每个行业、每条查询或每个平台。谷歌还说明,用户触发的代理抓取处于 robots.txt 定义的部分边界之外,因此团队需要进一步确认具体代理的请求方式与适用控制。本文也不把付费新闻稿中的机构自报数字视为独立实验、谷歌排名承诺或普遍行业基准。