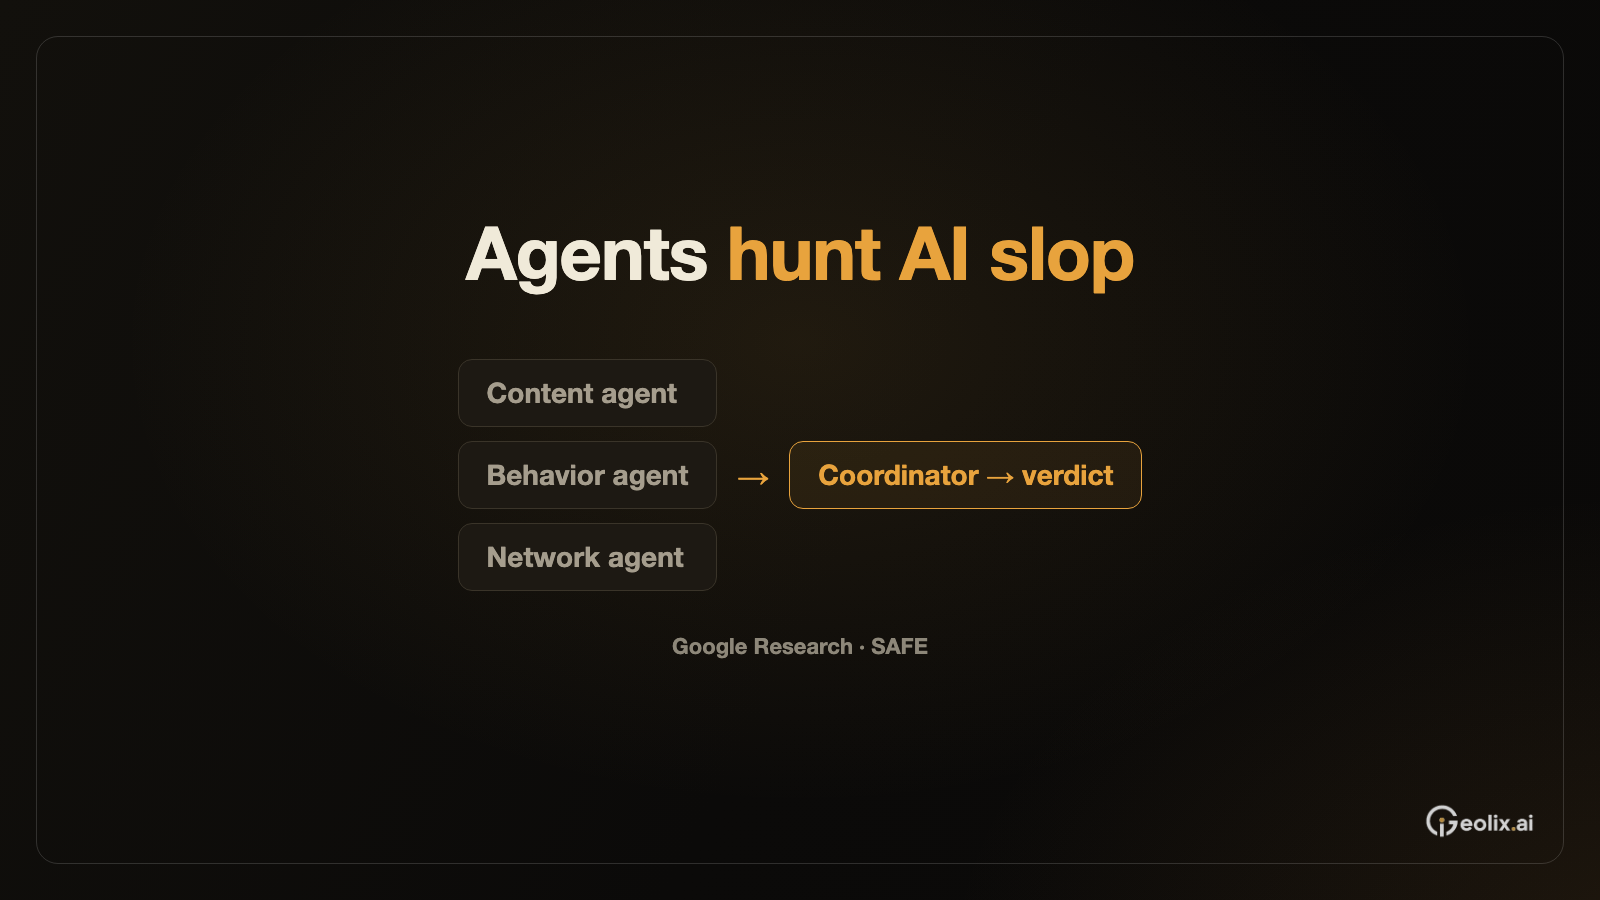
Google 研究人员介绍了一套名为 SAFE 的自动化取证架构,用多个 AI 智能体分工调查合成媒体滥用网络,再由协调智能体综合判断。团队称,早期部署缩短了调查时间,但公开说明没有给出具体提速幅度。Google Research 论文页只标注了 2026 年,没有具体日期;Search Engine Journal 于9月25日报道了这篇论文。
论文关注的难点是,有组织的发布者可以批量生成彼此不同、经过本地化调整的合成内容。单条上传内容未必构成明显重复,背后的账号却可能表现出相近的活动规律。依靠人工检查内容、关系及行为,处理速度难以跟上新增材料的规模。SAFE 的设计围绕这类取证任务展开。
负责内容的智能体使用大语言模型分析违规特征。按研究摘要,团队通过 LoRA 适配处理已知违规类别,并利用少样本学习识别违背政策意图的模式。这一部分描述的是对滥用和违规的调查,不能从中推导出“只要由 AI 生成就会被处罚”的通用规则。
另外两个智能体分别观察行为和频道集群关系。行为分析寻找时间、空间上的非自然模式,集群分析检查频道之间的联系。Search Engine Journal 对论文的解读提及共用基础设施、同步发布等线索,说明研究人员考虑的证据范围超出某一条内容本身。协调智能体在收到这些分析后作出综合判断。
研究摘要还提到使用多模态信号。团队未公布面向站长开放的工具,也未介绍供外部查看 SAFE 判定结果的报表。
效果披露同样有限。研究团队称,系统比包含人工审核的流程更快识别新型合成威胁。Search Engine Journal 指出,这篇三页论文没有分享测试结果。公开材料未给出具体效率增幅、误判率或独立评估,无法据此完成与其他检测系统的定量比较。
有关 Google 搜索的推论需要与研究本身分开。行业报道提出 SAFE 可能与九月垃圾内容更新有关,但这属于报道中的推测,并非研究团队确认的部署关系。摘要所描述的是合成媒体、视频集群、频道及协调网络,没有认定 SAFE 就是那次搜索更新背后的系统,也没有证明普通 AI 辅助文章因此受到排名惩罚。