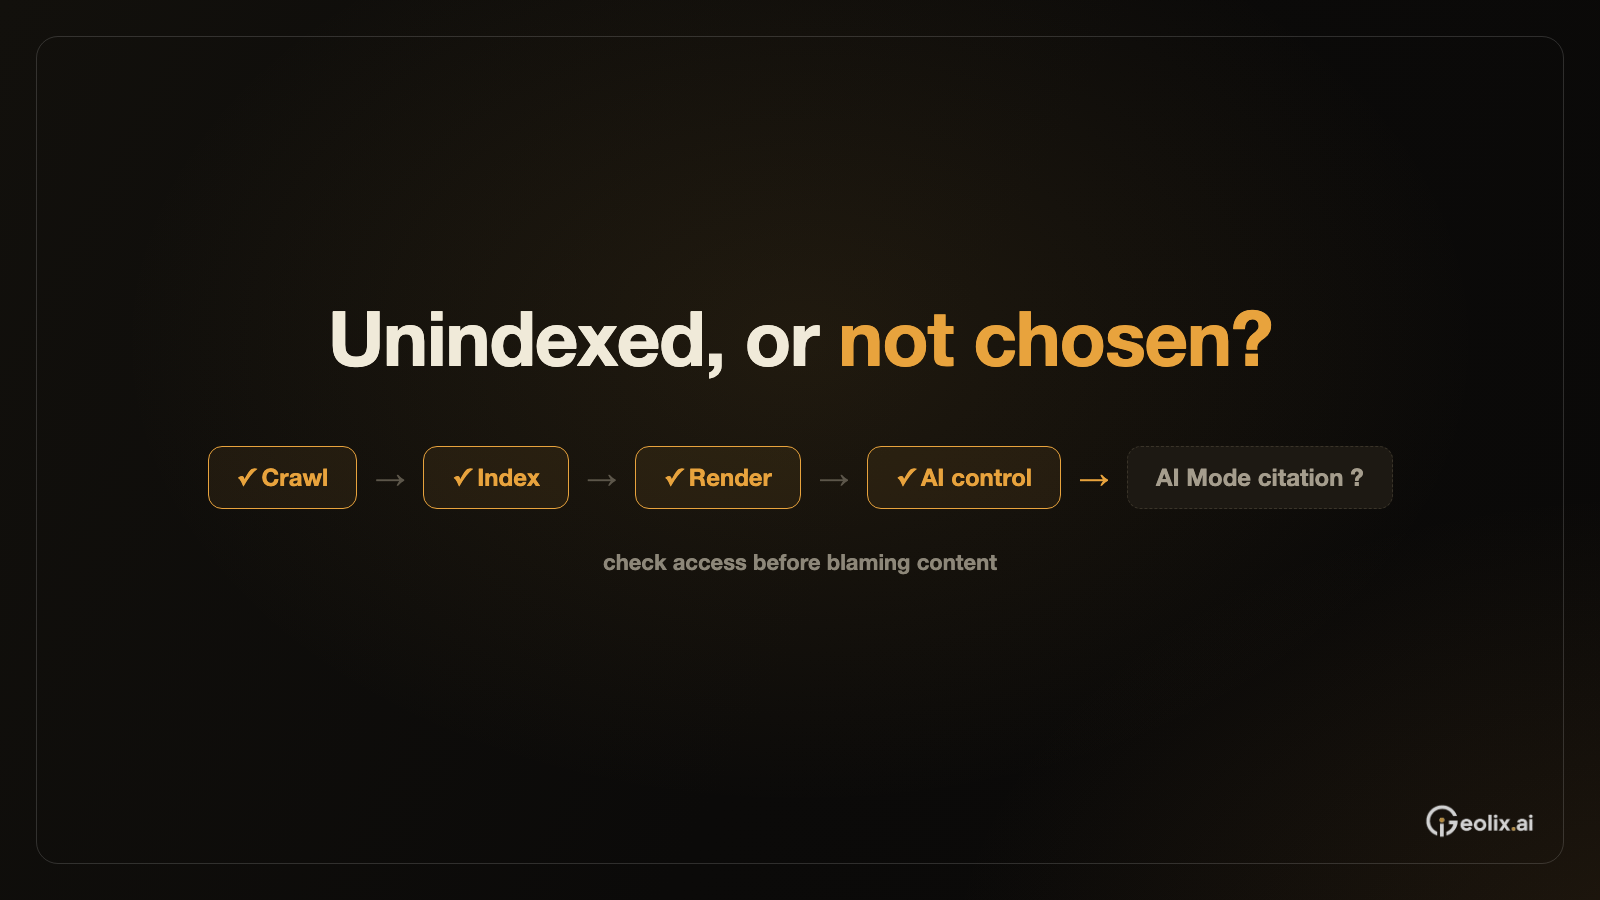
如果一个页面在普通搜索中很少出现,就很难判断它在 AI 搜索中为什么缺席。在追问“AI 为什么没有引用它”之前,应先确认目标页面能否被发现、抓取和收录。按这个顺序排查,可以避免把每一次引用缺失都当作内容问题。Google 表示,页面要进入其生成式 AI 功能,必须满足搜索技术要求,并具备以摘要形式出现在搜索结果中的资格。Google Search Central 的 AI 优化指南明确列出了这一前提。
从一个具体 URL 开始
从一个具体 URL 和一个具体预期开始。例如,某个价格说明页本应被找到,就在 Search Console 的 URL 检查工具中查看那个确切地址。记录报告的索引状态,以及 Google 选定的规范 URL。如果页面未被收录,用实时测试观察 Google 目前能访问到什么。索引报告还能帮助判断问题只发生在单页、某个页面模板,还是更大的站点区域。Google 的 Search Console 指南解释了这些报告和 URL 检查工具各自的作用。
检查访问规则与实际页面
接着检查访问规则与实际呈现的页面。robots.txt 规则可能阻止抓取;在允许抓取的情况下,noindex 指令可能阻止收录。如果主要答案要等脚本运行后才出现,就确认 Google 能加载必要资源并看到内容。还要检查重复 URL 或规范化选择是否把 Google 引向了另一页。这些控制手段解决的是不同问题,没有弄清报告中的原因就随意修改,反而会让排查更难。Google 的开发者 SEO 指南区分了抓取限制与索引限制。
如果页面刚发布或最近才修复,要给重新抓取留出时间。站点地图可以帮助 Google 发现大量 URL;对于自己管理的单个 URL,可以在 URL 检查工具里请求抓取。但两者都不保证页面立即被收录或展示。反复请求同一个 URL,也不会让抓取变快。Google 的重新抓取指南说明了这些边界。
再看 AI 功能设置与数据
弄清普通搜索中的访问情况后,再查看 Google 生成式 AI 功能的专有控制项。Search Console 在网站资源设置中提供“Search generative AI”控制,可选择是否允许网站的链接和内容进入 AI Overviews、AI Mode 等功能。一个资源可能继承父级资源的设置,因此要查看实际生效的选项,不能只假设它使用默认值。Google 表示,这项选择针对这些 AI 功能,普通搜索另有不同的控制方式。Search Console 帮助文档解释了设置及继承规则。
到这一步,AI 可见性数据才有可解释的基础。Search Console 的生成式 AI 效果报告可以显示哪些页面出现过、何时出现。没有展示次数是一条有用的观察,却不能单独指出原因。保留完整的排查链条:预期出现的 URL、抓取权限、实际内容、索引状态、AI 功能设置,以及观察到的效果。这样,团队才能判断是该修复技术障碍、改进薄弱的答案,还是继续观察一个符合资格但尚未出现的页面。Google 的报告公告列出了可用数据。
参考资料
Google Search Central:《Optimizing your website for generative AI features on Google Search》,用于核对 AI 功能的网页资格。
Google Search Central:《Get started with Search Console》,用于核对 URL 检查和索引报告。
Google Search Central:《Get started with Search: a developer's guide》,用于核对抓取与索引控制。
Google Search Central:《Ask Google to recrawl your URLs》,用于核对重新抓取的方式与限制。
Google Search Console Help:《Search generative AI control》,用于核对 AI 功能参与设置。
Google Search Central:《Introducing Search Generative AI performance reports in Search Console》,用于核对效果报告的指标。